Jev vs. LLM: ¿decisiones tipadas o lenguaje abierto?
Una empresa recibe decenas de mensajes de clientes. Algunos piden cotización, otros reportan fallas y otros solo quieren saber el horario. ¿Necesitas una IA que escriba un ensayo sobre cada correo? Probablemente no.

Una empresa recibe decenas de mensajes de clientes. Algunos piden cotización, otros reportan fallas y otros solo quieren saber el horario. ¿Necesitas una IA que escriba un ensayo sobre cada correo? Probablemente no. Antes de elegir herramienta, pregunta qué salida necesita el proceso: una decisión entre opciones conocidas, una explicación abierta o una persona responsable.
La respuesta corta
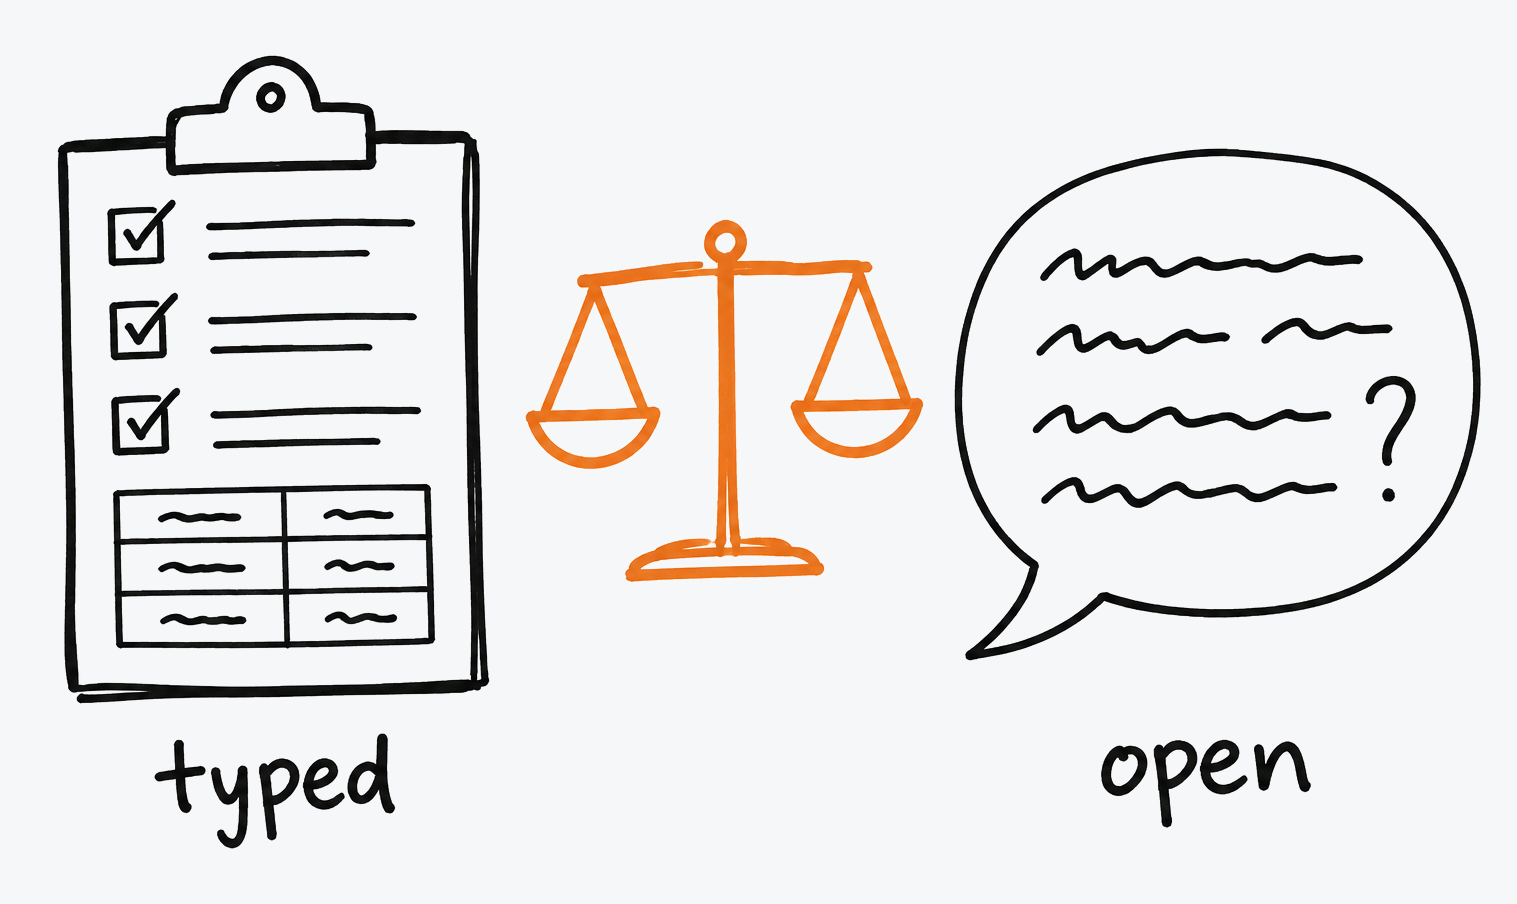
Un modelo de decisiones con salidas definidas, como Jev de TypeSafe AI, puede clasificar, puntuar o estimar la probabilidad de una respuesta sí/no. Un modelo grande de lenguaje (LLM) puede redactar, resumir y explorar preguntas abiertas. Ninguno debe decidir por sí solo qué hacer con dinero, datos sensibles o personas. Las reglas del negocio, el código y un responsable fijan el límite.
La explicación base del otro lado de la comparación: qué es un LLM y para qué sirve.
Jev está en acceso temprano. No es una compra obligatoria ni una solución probada para todos los negocios. La pregunta útil es qué parte del trabajo requiere juicio repetible y qué parte requiere lenguaje.
Un ejemplo: la bandeja de soporte
Imagina una empresa de servicios que recibe tickets. Este caso es inventado; no representa la operación ni los resultados de Jonathan. Primero, el equipo define sus rutas: ventas, soporte y facturación, con una opción para casos que no encajan. Luego prueba tres preguntas sobre cada solicitud:
- Choice: ¿a cuál de esas rutas pertenece el ticket? Devuelve una opción definida y una distribución de probabilidades.
- Score: ¿qué nivel de urgencia describe mejor el mensaje según una escala definida por el equipo?
- Noul: ¿el cliente pide un reembolso? Devuelve una probabilidad de sí, no una decisión de pagar.
En Jev, esas preguntas pueden enviarse juntas sobre el mismo estado. Después, el código aplica las políticas: asigna una sugerencia de ruta cuando el riesgo es bajo, pide revisión cuando hay duda y nunca autoriza un reembolso solo porque una puntuación salió alta. Si hace falta escribir una respuesta clara al cliente, un LLM prepara un borrador para que lo revise una persona. No le damos las llaves de la caja al clasificador por parecer seguro de sí mismo.
¿Y un LLM no puede devolver datos estructurados? Sí puede. La diferencia no es «texto contra números» como una ley universal. Jev está diseñado específicamente para preguntas tipadas con opciones predeterminadas y probabilidades; muchos LLM también admiten esquemas o salidas estructuradas. Compara ambos con el mismo trabajo y valida la salida de cualquiera.
La tabla mental para elegir
- Regla fija: si el dato ya determina la respuesta sin ambigüedad, usa código normal. «Si vence hoy, marcar vencido» no necesita IA.
- Juicio repetible: si un humano reconoce patrones pero escribir una regla para cada caso es frágil, prueba clasificación o puntuación tipada.
- Lenguaje abierto: si necesitas explicar, redactar, resumir o conversar, prueba un LLM con revisión acorde al riesgo.
- Decisión delicada: si afecta derechos, dinero, seguridad o privacidad, mantén control humano, políticas claras y una ruta para detenerte.
Cómo probar sin humo
Toma ejemplos representativos, con permiso y datos protegidos. Define de antemano la respuesta correcta o un criterio de revisión, y compara una regla simple, un LLM con salida estructurada y, si tienes acceso, Jev. Cuenta errores por tipo: confundir una duda con ventas no pesa igual que perder una queja urgente. Mide también tiempo de respuesta, costo total, estabilidad y cuánto trabajo de revisión crea cada opción. Comprueba si las probabilidades corresponden a resultados reales antes de tratarlas como niveles fiables de riesgo. Pon umbrales y un camino de abstención o escalamiento; no conviertas 87% en garantía.
Si quieres correr un LLM sin que tus datos salgan de la oficina: IA que programa en tu propia computadora: LLM locales.
TypeSafe presenta cifras llamativas de velocidad y costo en sus propias evaluaciones, pero reconoce condiciones favorables en una demostración y posibles sesgos de sus flujos de prueba. Son resultados del proveedor, no promesas para tu empresa. También dice que sus salidas no pueden incumplir el tipo definido: eso evita errores de formato, no decisiones equivocadas. Incluso una respuesta perfectamente formada puede estar mal.
Tu siguiente paso
Elige un juicio repetitivo de bajo riesgo. Escribe las opciones permitidas, quién revisará los casos dudosos, qué error obligaría a parar y cómo medirás la situación actual. Después prueba en pequeño. La mejor herramienta no es la que se ve más futurista en una lámina, sino la que ayuda sin esconder el costo de equivocarse.
Fuentes y nota editorial
Inspiración: reel de Brij Kishore Pandey (@codewithbrij), 28 de septiembre de 2026: https://www.instagram.com/reel/Dd23pmFOxme/. Funcionamiento y límites declarados: TypeSafe AI, «Introducing System One Models and Jev»: https://typesafe.ai/blog/introducing-system-one-models-and-jev; documentación de primitivas: https://docs.typesafe.ai/primitives. Las afirmaciones comparativas de rendimiento son del proveedor y requieren prueba independiente en cada flujo.
¿Te fue útil este artículo?