IA que programa en tu propia computadora: LLM locales, en claro
Imagina contratar a un programador que nunca duerme, no cobra por hora y —esto es lo importante— nunca saca información de tu oficina. Eso, más o menos, es lo que promete la nueva generación de modelos de inteligencia artificial que corren en tu propia computadora.

Imagina contratar a un programador que nunca duerme, no cobra por hora y —esto es lo importante— nunca saca información de tu oficina. Eso, más o menos, es lo que promete la nueva generación de modelos de inteligencia artificial que corren en tu propia computadora. Se llaman LLM locales y en 2026 dejaron de ser un juguete de entusiastas para convertirse en una opción real para empresas.
Si quieres primero la explicación base: qué es un LLM y para qué sirve.
¿Qué es un LLM local y por qué debería importarte?
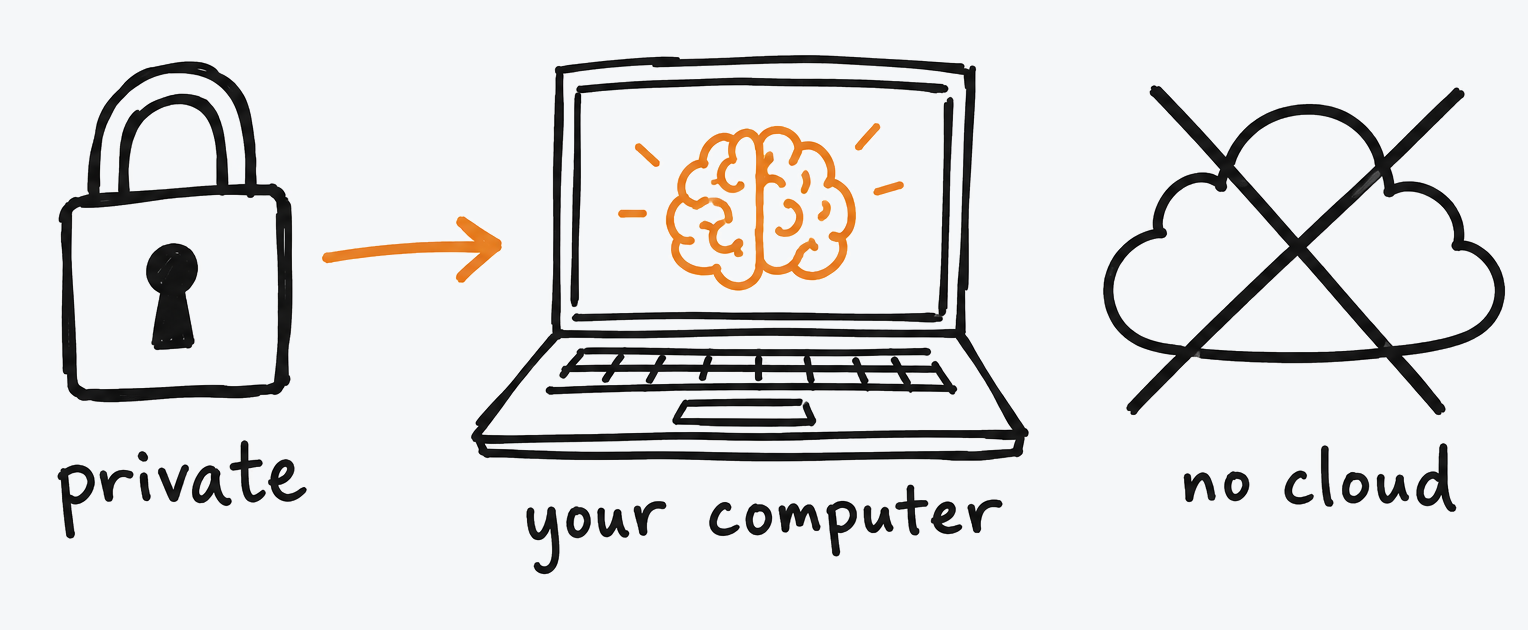
Un LLM (modelo grande de lenguaje) es el motor detrás de herramientas como ChatGPT o Claude. Normalmente vive en los servidores de un proveedor y cada pregunta que le haces viaja por internet hasta allá. Un LLM local es lo mismo, pero descargado y ejecutado en tu propio equipo: la computadora de tu oficina o incluso una Mac bien equipada. Los modelos de «pesos abiertos» se descargan gratis y el software para correrlos también.
Tres razones de negocio para voltear a verlos. Primero, privacidad: tu código y tus datos nunca salen de tu máquina; si manejas código propietario, trabajo de clientes o algo bajo un NDA, es la única opción que lo mantiene todo en casa. Segundo, costo: no hay factura por token ni suscripción, generes lo que generes. Tercero, independencia: funciona sin internet y sin límites de uso.
¿Qué tan buenos son ya?
La foto honesta: los mejores modelos abiertos rondan 80% en SWE-bench Verified, una prueba donde el modelo debe resolver problemas reales de software publicados en GitHub. Los modelos más grandes de la nube andan por 90-95%. Traducción: para el trabajo de todos los días ya están cerca; para los problemas más difíciles, la nube sigue ganando. Estas cifras vienen de las evaluaciones que publican los propios fabricantes, así que conviene leerlas como dirección y no como promesa.
Los nombres que suenan en 2026
La guía de Atomic Chat probó varios modelos en la misma computadora y estas son las conclusiones útiles para un no ingeniero:
- Qwen3-Coder 30B (Alibaba): el mejor para uso diario. Fue el más rápido de su prueba con mucha diferencia (220 tokens por segundo) y cabe en una sola tarjeta gráfica de 24 GB.
- Qwen3.6 27B (Alibaba): el más preciso que cabe en una máquina casera, con 77.2% en SWE-bench Verified según las cifras de Qwen. Más lento, porque usa todos sus parámetros en cada respuesta.
- Gemma 4 26B A4B (Google): el más amable con equipos modestos; arranca desde unos 12 GB de memoria de video.
- Laguna S 2.1 (Poolside): el más capaz para trabajo autónomo largo, pero pide una máquina seria (67-96 GB de memoria).
Un detalle que me encanta de la prueba original: el modelo con mejores números oficiales fue el único que falló su simulación de física. Los benchmarks no programan por ti; hay que probar con tus tareas reales.
¿Qué necesitas para correr uno?
La regla rápida: con la compresión estándar (cuantización a 4 bits, que achica el modelo perdiendo poca calidad), necesitas más o menos 1 GB de memoria por cada mil millones de parámetros. El punto dulce está en modelos de 27-34 mil millones de parámetros: 16-24 GB de memoria, o sea una buena tarjeta de video gamer (tipo RTX 4090) o una Mac con 24-32 GB de memoria unificada. El software es gratis —Atomic Chat, Ollama o LM Studio— y el modelo se conecta a las herramientas de programación habituales a través de una API estándar, igual que si fuera un servicio de nube.
¿Le entras o no?
Mi lectura: si tu empresa maneja código sensible o datos de clientes que no pueden salir por ahí, los LLM locales ya merecen una prueba seria. Si solo tienes curiosidad o necesidades ocasionales, la nube sigue siendo más simple y más fuerte en la punta. La pregunta correcta no es «¿cuál es el mejor modelo?» sino «¿cuál cabe en mi máquina y resuelve mi problema de privacidad?». Y como siempre por aquí: prueba en pequeño, mide, y no le creas a ninguna lámina.
Si la prueba la quieres correr con esta forma de trabajar: qué es vibe coding, cómo hacerlo bien y para quién.
Fuentes y nota editorial
Inspirado por la guía de Atomic Chat «Best Local LLM for Coding in 2026» (junio 2026, actualizada en agosto): https://atomic.chat/blog/guides/best-local-llms-for-coding. Fichas oficiales: Qwen3-Coder y Qwen3.6 (Hugging Face), Gemma 4 (Google DeepMind) y Laguna S 2.1 (Poolside). Las cifras de rendimiento son reportadas por los fabricantes o por la prueba de un solo sitio; verifícalas antes de citarlas.
¿Te fue útil este artículo?